前言:不久前做了Windows 10的重大更新,更新完就發現開不了機,一直卡在黑畫面轉圈圈,上網查了很多相關方法都失敗,最後只能重灌。原本以為是更新未完成,又強制重開機造成更新失敗,但重灌完並確認更新完成,隔天重開機發現又卡在同樣情況,表示應該不是重灌不完全造成。詳細發生原因不能確定,但歸納出一些解決方法。
解決:
1. 首先,若想要進入系統,除了網路上所說盡量把一些外接裝置(ex. USB滑鼠)都拔掉再開機之外,還可以試著將系統硬碟之外的硬碟都拔除,這個方法尤其適合將系統裝在SSD硬碟的人。
2. 進入系統後,在設定->電源與睡眠->其他電源設定->選擇按下電源按鈕時的行,先按"變更目前無法使用的設定",再將開啟快速啟動(建議選項)關閉。
2017年7月5日 星期三

2016年6月26日 星期日
Synology NAS在雙路由器下的port forwarding設定方法
在安裝好NAS之後,若要使用像是Synology在手持裝置上提供的DS file,可能需要對路由器做port forwarding設定。如果今天我們的NAS是經過兩個路由器連接後才進入網際網路,那就要對兩個路由器都設定port forwarding。
我的網路連接狀況如下(圖1)

首先我們要先弄清楚我們機器的IP。在DSM 6.0.1下,NAS的IP可以在控制台->網路->網路
介面->區域網路->IP位址下找到(圖2)


[2016/6/29]更新: 固定IP設定
我們的路由器為了方便多台電腦使用,通常是設定DHCP,也就是浮動IP。這樣的設定可以讓電腦在接上網路線後,自動偵測使用的IP位址,而不用再多做設定。我們可以在圖7中看到,Router 1的IP顯示為浮動IP。這樣的設定有個嚴重的缺點,就是這個位址可能會變換。假如哪天Router 1的IP變成了192.168.1.150,那麼Router 2的封包將會轉送到原來的192.168.1.111位址,而這不是我們想要的結果。第一種解決方法就是,當Router 1的位址改變時,就到Router 2更改轉送的設定,將所有的位址都改成新位址。這當然是個很爛的方法,因此更好的方法應該是使用固定IP。如圖15,到Router 1的網路設定,將連線類型從浮動IP改為固定IP。接下來輸入你想要的IP位址,這個位址可以參考Router 2的設定資訊(圖16),在範圍內的位址都可以使用,例如我選擇192.168.1.150。接下來在Router 2的設定轉送的封包到這個位置(192.168.1.150)就完成了(圖17)。


我的網路連接狀況如下(圖1)

圖1
介面->區域網路->IP位址下找到(圖2)

圖2
這個位址(192.168.0.101)就是Router 1分配給NAS的位址。若我們打開電腦上控制台->網路和網際網路->網路和共用中心->變更介面卡設定->乙太網路->狀態->詳細資料->IPv4位址,我們可以看到我們電腦的位址(圖3)

圖3
可以看到這個位址(192.168.0.100)和NAS的位址只差了1號,這是因為router在分配位址時習慣相差1號。
接下來我們要知道Router 1的位址,這可以在Router 1的管理頁面找到。我們可以在NAS上的控制台->網路->一般->一般->預設閘道器(gateway)(圖4)或是電腦上的控制台->網路和網際網路->網路和共用中心->變更介面卡設定->乙太網路->狀態->詳細資料->IPv4 預設閘道(圖5)看到

圖4

圖5
我們在瀏覽器上輸入這個位址(192.168.0.1)即可登入Router 1的管理頁面(圖6)

圖6
這個畫面每家路由器都不太一樣,我是以TP-LINK為例。在狀態->網際網路(WAN)找到IP位址以及預設閘道(圖7),IP位址(192.168.1.111)就是Router 2給Router 1分配的位址,預設閘道(192.168.1.1)即為我們登入Router 2管理畫面的位址。

圖7
在瀏覽器輸入預設閘道位址(192.168.1.1),進入Router 2的管理畫面。可以在IP位址找到網際網路的IP位址(圖8)

圖8
現在我們可以知道我們網路整體的位址狀況了(圖9)

圖9
port forwarding的目的就是讓路由器看到特定port的封包時,可以按照設定的方式轉送給特定的區域網路IP。我們進入Router 1的管理畫面,並進入通訊埠導向(圖10)

圖10
點選新增,照圖11的方式進行設定

圖11
IP位址的部分填上要導向的IP位址,因為Router 1要導向NAS,因此填入NAS的IP(192.168.0.101)。服務通訊埠和內部通訊埠兩個選項,在有些路由器中稱為通訊埠開始以及通訊埠結束,就填上服務的port編號,以Synology的DS file為例,是5000。兩個都填一樣就可以了。通訊協定是TCP。這些在Synology的說明網站可以找到(https://www.synology.com/zh-tw/knowledgebase/DSM/tutorial/General/What_network_ports_are_used_by_Synology_services)。
接下來在Router 2的管理畫面,一樣找到類似port forwarding的選項(圖12)

圖12
點Add,照圖13的方式進行設定

圖13
這個路由器多了可以輸入服務名稱的功能,不過應該不是很重要就是了。因為Router 2要轉送封包給Router 1,因此IP位址輸入Router 1的位址(192.168.1.111),External Port Start和External Port End和剛才的服務通訊埠和內部通訊埠意思相同,填入5000,這樣設定就完成了。
現在我們可以在DS file中輸入我們的網際網路IP位址,以及NAS的帳號和密碼(圖14
)。這樣當我們的Router 2接收到port為5000的封包時,就會自動轉送到Router 1,Router 1接著會再將封包送到我們的NAS中。
圖14
[2016/6/29]更新: 固定IP設定
我們的路由器為了方便多台電腦使用,通常是設定DHCP,也就是浮動IP。這樣的設定可以讓電腦在接上網路線後,自動偵測使用的IP位址,而不用再多做設定。我們可以在圖7中看到,Router 1的IP顯示為浮動IP。這樣的設定有個嚴重的缺點,就是這個位址可能會變換。假如哪天Router 1的IP變成了192.168.1.150,那麼Router 2的封包將會轉送到原來的192.168.1.111位址,而這不是我們想要的結果。第一種解決方法就是,當Router 1的位址改變時,就到Router 2更改轉送的設定,將所有的位址都改成新位址。這當然是個很爛的方法,因此更好的方法應該是使用固定IP。如圖15,到Router 1的網路設定,將連線類型從浮動IP改為固定IP。接下來輸入你想要的IP位址,這個位址可以參考Router 2的設定資訊(圖16),在範圍內的位址都可以使用,例如我選擇192.168.1.150。接下來在Router 2的設定轉送的封包到這個位置(192.168.1.150)就完成了(圖17)。

圖15

圖16

圖17
2016年4月10日 星期日
ERB Transforms
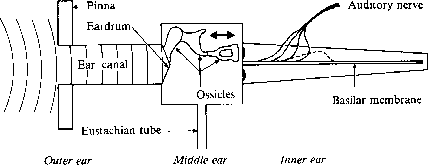
人內耳中的basilar membrane(基底膜)有許多的聽覺神經,而這些神經對於不同頻率的聲波各有其敏感度。因此,根據研究,德國科學家巴克豪森(Barkhausen)透過實驗,將聲波區分為24個關鍵頻帶(Critical Bands),並稱之為巴克刻度(Bark scale)。人耳對於相鄰頻帶會有相同距離的感覺。我們知道,人耳對於聲波能量強度的感受大致是對數變化的,但實際上,這個感受可能比單純的對數還要更複雜,因此才會有科學家進一步去研究這種更精緻的對應關係。這種對應是根據主觀實驗得來的,因此不同人的感受會有些微差距。關鍵頻帶之所以稱為'頻帶',就是因為它並不是一個數值,而是一個範圍,同一個範圍內的頻率大致上感受都會差不多。
Bark scale critical bands
| Number | Center Frequency (Hz) | Cut-off Frequency (Hz) | Bandwidth (Hz) |
|---|---|---|---|
| 20 | |||
| 1 | 60 | 100 | 80 |
| 2 | 150 | 200 | 100 |
| 3 | 250 | 300 | 100 |
| 4 | 350 | 400 | 100 |
| 5 | 450 | 510 | 110 |
| 6 | 570 | 630 | 120 |
| 7 | 700 | 770 | 140 |
| 8 | 840 | 920 | 150 |
| 9 | 1000 | 1080 | 160 |
| 10 | 1170 | 1270 | 190 |
| 11 | 1370 | 1480 | 210 |
| 12 | 1600 | 1720 | 240 |
| 13 | 1850 | 2000 | 280 |
| 14 | 2150 | 2320 | 320 |
| 15 | 2500 | 2700 | 380 |
| 16 | 2900 | 3150 | 450 |
| 17 | 3400 | 3700 | 550 |
| 18 | 4000 | 4400 | 700 |
| 19 | 4800 | 5300 | 900 |
| 20 | 5800 | 6400 | 1100 |
| 21 | 7000 | 7700 | 1300 |
| 22 | 8500 | 9500 | 1800 |
| 23 | 10500 | 12000 | 2500 |
| 24 | 13500 | 15500 | 3500 |
其中,center frequency表示每個頻帶的中間值,也就是說,若想只用一個頻率值代表一個頻帶的話,就是用center frequency。cut-off frequency就是頻帶的最大和最小值。bandwidth是頻寬,表示一個頻帶的寬度(最大值-最小值)。


Bark scale只定義了24種頻率的對應方式,但是到底要如何對每個頻率f都找到一個對應的Bark scale值呢?研究人員開始試著找出一些數學式來近似這種對應,而ERB(Equivalent Rectangular Bandwidth)就是其中的一種對應方式。
ERB scale指的是有幾個ERB在給定的頻率f以下
2016年3月27日 星期日
python multiprocessing卡住解決辦法
使用python開多個process平行運算時,可能要將最終結果放入某個list、dictionary或queue之類的回傳至主程式,這時候有機會出現子程序無法結束(terminate)的問題,不知道這是否和官方文件所說的問題一樣
https://docs.python.org/2/library/multiprocessing.html#pipes-and-queues
總之,若出現這種問題,不妨將所使用的list、dictionary或是queue改成manager版本的,用法上差不多,儘量使用class的界面來操作的話問題會比較少(例如不能使用ls=ls+[...],應該使用正常的ls.append(...)),因為manager是專門用來處理multiprocessing的module,大致上可以解決這些問題。
關於thread的簡易用法
http://puremonkey2010.blogspot.tw/2012/05/python-python.html
2016年3月16日 星期三
工作站安裝Caffe
這次安裝是在實驗室的工作站上,除了環境設定和自己電腦稍有不同外,權限也較低,所以不能隨便想裝什麼就裝什麼。
首先是為什麼現在會突然想到工作站上安裝,原因是因為我自己寫了一個layer,因此要重新編譯caffe,所以才想說順便裝一下以前在工作站上沒裝成功的pycaffe。
筆記一下要如何自己寫一個layer:基本上只要在自己的layer.cpp最後加上
INSTANTIATE_CLASS(xxxLayer);
REGISTER_LAYER_CLASS(xxx);
即可,當然還要有自己的header檔,看是要自己新增一個,還是加到原本就有的裡面。
接下來是如何在工作站上安裝pycaffe。由於工作站無法自己安裝新的python module,但幸好python可以整個安裝成自己的,所以我下載了anaconda2 python,安裝完即可使用。當然還是要記得將build/CMakeCache.txt中python的路徑設定為新裝的anaconda的位置,不然他還是會找到系統原始的python。完成後,原本以為照著之前的做法,
cd build/
cmake ..
make all
就好了,結果卻發現工作站的OpenCV library有問題,不知道是版本問題還是什麼,總之這個library我一定也沒有權限可以修改,想要編譯自己的版本來安裝又太麻煩了,因此我想說能不能跳過OpenCV,因為需要使用OpenCV的檔案其實只是附加功能,而且我根本就沒有使用到這個功能。但這個cmake的設定似乎就是要嘛你根本沒裝OpenCV,他也不幫你裝相關功能,要嘛就他自己找到OpenCV就一定會安裝,就是沒有可以自己關掉的選項,最後只好放棄使用cmake,使用原始的makefile版本。基本上也不會太難,將Makefile.config.example改成Makefile.config,並且使用裡面的ANACONDA_HOME以及相關的python路徑即可,#註解記得該取消的要取消乾淨。接下來手動使用
make lib
make tools
make py
即可,example不需要編譯。
若出現缺少python module的問題,執行
cd python
for req in $(cat requirements.txt); do pip install $req; done
更新:
後來發現雖然pytest是成功的,但是shell的caffe卻不能用,而且不知道為什麼,cmake所找到的python library一直是系統的,推測可能因此有些相關的library發生衝突。總之目前還是回到原始沒有pycaffe的狀態,之後有空再研究。
有關cmake的find_package()到底會找哪些資料夾,這篇網站有介紹
https://cmake.org/Wiki/CMake:How_To_Find_Libraries#How_package_finding_works
首先是為什麼現在會突然想到工作站上安裝,原因是因為我自己寫了一個layer,因此要重新編譯caffe,所以才想說順便裝一下以前在工作站上沒裝成功的pycaffe。
筆記一下要如何自己寫一個layer:基本上只要在自己的layer.cpp最後加上
INSTANTIATE_CLASS(xxxLayer);
REGISTER_LAYER_CLASS(xxx);
即可,當然還要有自己的header檔,看是要自己新增一個,還是加到原本就有的裡面。
接下來是如何在工作站上安裝pycaffe。由於工作站無法自己安裝新的python module,但幸好python可以整個安裝成自己的,所以我下載了anaconda2 python,安裝完即可使用。當然還是要記得將build/CMakeCache.txt中python的路徑設定為新裝的anaconda的位置,不然他還是會找到系統原始的python。完成後,原本以為照著之前的做法,
cd build/
cmake ..
make all
就好了,結果卻發現工作站的OpenCV library有問題,不知道是版本問題還是什麼,總之這個library我一定也沒有權限可以修改,想要編譯自己的版本來安裝又太麻煩了,因此我想說能不能跳過OpenCV,因為需要使用OpenCV的檔案其實只是附加功能,而且我根本就沒有使用到這個功能。但這個cmake的設定似乎就是要嘛你根本沒裝OpenCV,他也不幫你裝相關功能,要嘛就他自己找到OpenCV就一定會安裝,就是沒有可以自己關掉的選項,最後只好放棄使用cmake,使用原始的makefile版本。基本上也不會太難,將Makefile.config.example改成Makefile.config,並且使用裡面的ANACONDA_HOME以及相關的python路徑即可,#註解記得該取消的要取消乾淨。接下來手動使用
make lib
make tools
make py
即可,example不需要編譯。
若出現缺少python module的問題,執行
cd python
for req in $(cat requirements.txt); do pip install $req; done
將相關python module安裝好即可。這裡我發現其實leveldb是沒有安裝成功的,因此若要使用pycaffe,應該使用lmdb或是hdf5。
更新:
後來發現雖然pytest是成功的,但是shell的caffe卻不能用,而且不知道為什麼,cmake所找到的python library一直是系統的,推測可能因此有些相關的library發生衝突。總之目前還是回到原始沒有pycaffe的狀態,之後有空再研究。
有關cmake的find_package()到底會找哪些資料夾,這篇網站有介紹
https://cmake.org/Wiki/CMake:How_To_Find_Libraries#How_package_finding_works
2016年2月24日 星期三
一篇有關Softmax的文章
找到一篇不錯的文章在介紹Softmax和Softmax loss
http://freemind.pluskid.org/machine-learning/softmax-vs-softmax-loss-numerical-stability/
http://freemind.pluskid.org/machine-learning/softmax-vs-softmax-loss-numerical-stability/
2016年2月18日 星期四
2016年2月16日 星期二
Matlab同時使用多核CPU和多張GPU加速
CPU的Multi-thread用法類似
p = gcp();
for i = 1 : iter
f(i) = parfeval(p, @myFunc, ...);
end
for i = 1 : iter
fetchNext(f);
end
而GPU則只需將陣列使用gpuArray宣告即可。但因為要使用多GPU,因此先使用
nGPU = gpuDeviceCount;
得到GPU的個數,然後呼叫數學函數前記得先用gpuDevice()選擇要用哪張GPU
gpuDevice(GPU_index) % 1 <= GPU_index <= nGPU
math_func(...)
...
搭配前面的CPU multi-thread即可同時使用多張GPU運算。
注意事項:
使用Multi-thread CPU + Multi-GPU時,記得[1]要自己安排讓#(nGPU)個函式用CPU+GPU執行,[2]剩下#(nCPU-nGPU)個只使用CPU單獨。[1]可避免太容易出現GPU out of memory,[2]可增加效能。
2016年2月14日 星期日
mac上使用multi-thread(OpenMP)
OpenMP是常見的multi-thread library,他有不同的實作。而Mac使用的compiler有gcc或clang,因此OpenMP也有相對應的實作。
參考:
gcc: https://gcc.gnu.org/projects/gomp/
clang: http://clang-omp.github.io/
參考:
gcc: https://gcc.gnu.org/projects/gomp/
clang: http://clang-omp.github.io/
2016年1月28日 星期四
AMD顯示卡玩Diablo 3閃退/畫面卡住問題
用AMD的顯示卡玩暗黑3第二章淒涼砂地時,容易發生閃退或是畫面停住不動的情形,這是因為某次暗黑改版後開始發生和新的AMD驅動程式(15.x)不相容的情形。官方的解法是將顯示卡驅動程式版本降到13.12,只是不是每個作業系統都可以這麼容易的降版本(e.g Windows 10),且為了玩暗黑而降低驅動版本聽起來也是怪怪的。因此,一個比較好的解法是,仍然降低驅動版本,但不是改變整個系統的驅動,而是只改變暗黑自己使用的驅動版本。方法是將AMD驅動的動態函式庫直接放到遊戲安裝目錄下,這樣遊戲就會優先讀取安裝目錄下的驅動了。
可以從以下網址
https://mega.nz/#F!8tlAhDyQ!2AkAQukJKAYuIWEzDTGtFA!IslFkTSL
選擇13.12.zip來下載,將目錄下的.dll檔都丟進遊戲安裝目錄就可以了。
可以從以下網址
https://mega.nz/#F!8tlAhDyQ!2AkAQukJKAYuIWEzDTGtFA!IslFkTSL
選擇13.12.zip來下載,將目錄下的.dll檔都丟進遊戲安裝目錄就可以了。
2016年1月26日 星期二
小技巧
使用numpy的array時,若我們想取出其中一個值,且使用類似
ary[1,2]
的方式,結果會是一個ndim為0的array。若我們希望可以維持結果的ndim還是和原本一樣,但又不想用
ary[1,2,None,None]
這種自己添加singleton的方式的話,還可以使用
ary[1:2,2:3]
另外,就算array的某個維度的大小是1,使用ary[..., :, ...]的方式取值(而不是
ary[..., 0, ...])的話,就能保持該維度1的大小。
在python中,若要判斷一個值是否為零,應該使用
if not val
而不是像C的
if ~val
因為~是binary的complement
使用numpy的array時,若要複製一個array到另一個變數,而不只是指向相同instant的話,應該使用
A = np.copy(B)
而不是
A = B
使用terminal連到其他電腦時,若要運行一個要跑很久的程式,可能會想在執行後將terminal關掉,將來再連回去,這時可以使用screen指令。首先在執行程式之前,執行
screen
然後接下來正常執行要跑的程式即可。當想要離開時,按下
Ctrl+a
然後在按
d
即可detach這個screen。想要回復screen,只要使用
screen -r
即可。更多使用可參考
http://blogger.gtwang.org/2013/11/screen-command-examples-to-manage-linux-terminals.html
Ctrl+a [ 可進入游標移動模式
ipython實用快捷鍵
http://cmdlinetips.com/2013/01/eleven-ipython-keyboard-shortcuts-to-move-around-easily/
python中print參數的方法
http://www.python-course.eu/python3_formatted_output.php
我們可以使用x=gpuArray(...)來建立一個儲存在GPU中的矩陣,若要確定這個變數是存在GPU中,可以使用class(x),會發現他確實是一個gpuArray的物件。此外,可以使用whos指令來查看目前工作區的變數資訊,可以發現gpuArray的物件大小都固定是108個Bytes,這是因為此變數確實是占用gpu的記憶體。
2016年1月24日 星期日
使用caffe.Net創建和讀取model
我們可以使用
(1)最後一個參數caffe.TRAIN或是caffe.TEST指的是要讀取net.prototxt中的phase TRAIN還是phase TEST的網路,兩個網路的差別就在於那些include不同phase的layer。而若使用solver來讀取網路,他會幫我們兩個都讀取,並分別放在solver.net和solver.test_nets裡面。
(2)當我們讀進預先訓練好的網路時,若我們使用
caffe.Net('net.prototxt', caffe.TRAIN)caffe.Net('net.prototxt', 'pretrain.caffemodel', caffe.TRAIN)(1)最後一個參數caffe.TRAIN或是caffe.TEST指的是要讀取net.prototxt中的phase TRAIN還是phase TEST的網路,兩個網路的差別就在於那些include不同phase的layer。而若使用solver來讀取網路,他會幫我們兩個都讀取,並分別放在solver.net和solver.test_nets裡面。
(2)當我們讀進預先訓練好的網路時,若我們使用
net.blobs['layer_name'].datanet.params['layer_name'][0].data2016年1月23日 星期六
一些筆記2
可以直接使用matlab的mat檔來當作caffe網路輸入的資料庫資料,但有注意事項:
(1) caffe和python中numpy的array是相同的格式(row major),和matlab(column major)不同。因此,在用matlab輸出mat檔前,記得要用permute()將資料dimension的order倒過來。且若要使用reshape(),維度順序也要注意不要弄錯。(應該是先permute後再做reshape)
(2)在caffe的prototxt中,資料層記得要使用HDF5Data,參數使用hdf5_data_param,source一個.txt檔,裡面放真正hdf5檔(也就是matlab的mat檔)的位置。
(3)python的h5py可以直接讀取matlab的mat檔,因為mat檔本身是hdf5格式。但如果是從python創建hdf5檔首先要注意(i)我們要將檔案關閉後他才會寫進硬碟裡,再來是(ii)matlab必須要使用
python界面使用caffe的方法:
(1)首先我們當然要先定義我們網路的內容,除了直接手寫prototxt檔之外,也可以使用python界面來產生。根據caffenet.py的範例,首先是將layers和params這兩個modules import進來,接下來就可以用
(2)有了網路的定義,接下來就是產生真正的網路資料結構。import pycaffe的Net(或直接import caffe),使用
net的forward()和backward()所需要的參數中,blobs是一個list的字串,start和end都是一個字串,這些字串都是layer的名稱(使用net.blobs.keys()可以查看)。因為呼叫forward()和backward()後,會回傳某些layer中的資料回來,blobs參數就是讓我們自定義還想"多"回傳哪些layer的blob。start和end用來表示要forward和backward的layer區間。kwargs是一個dict,可以讓我們指定某個layer要使用什麼樣的資料,我們可以使用
caffe的layer中有一個叫做HDF5Output,用處是將我們網路的結果輸出。若要使用,要注意他的input要有兩個[4](通常是一個data、一個label),然後使用
pycaffe中,forward、backward的參數kwargs其實是python中的keyword arguments,可以自己指定input,並會以dict的方式傳入函數[6]。
在caffe中使用dummy_layer的方式
layer {
name: "dummy"
type: "DummyData"
top: "dummy"
dummy_data_param {
shape {
dim: ...
dim: ...
}
data_filler {
type: "uniform"
min: ...
max: ...
}
}
}
參考:
(1) caffe和python中numpy的array是相同的格式(row major),和matlab(column major)不同。因此,在用matlab輸出mat檔前,記得要用permute()將資料dimension的order倒過來。且若要使用reshape(),維度順序也要注意不要弄錯。(應該是先permute後再做reshape)
(2)在caffe的prototxt中,資料層記得要使用HDF5Data,參數使用hdf5_data_param,source一個.txt檔,裡面放真正hdf5檔(也就是matlab的mat檔)的位置。
(3)python的h5py可以直接讀取matlab的mat檔,因為mat檔本身是hdf5格式。但如果是從python創建hdf5檔首先要注意(i)我們要將檔案關閉後他才會寫進硬碟裡,再來是(ii)matlab必須要使用
python:
f = h5py.File('filename')
f.create_dataset('datasetname', data=data_ary)
f.close()

matlab:
data = hdf5read('filename','datasetname')
才能讀取[3][5]。python界面使用caffe的方法:
(1)首先我們當然要先定義我們網路的內容,除了直接手寫prototxt檔之外,也可以使用python界面來產生。根據caffenet.py的範例,首先是將layers和params這兩個modules import進來,接下來就可以用
[top layer] = [layer type]([bottom layer], [parameters ...])(2)有了網路的定義,接下來就是產生真正的網路資料結構。import pycaffe的Net(或直接import caffe),使用
net = caffe.Net('proto_name.prototxt', caffe.TEST)
就可以產生一個網路資料的變數了。也可以在中間加入train過的model檔路徑來得到train過的model變數
net = caffe.Net('proto_name.prototxt', 'model.caffemodel', caffe.TEST)
net中的blobs包含了每層的資料資訊,使用net.blobs.items()可以列出所有blobs名稱。使用blob = net.blobs['blob_name']得到blob後,可用blob.data得到blob中的資料。
此外,也可以使用
solver = caffe.SGDSolver('solver_name.prototxt')
solver中除了也包含了solver.net的資訊外,也可以利用solver.solve()來自動forward、backward網路。若要使用之前的snapshot來回復solver的資訊,可以使用
solver.restore('snapshot.solverstate')
若是想要直接使用train好的model來finetune,可使用
net.copy_from('modelname. caffemodel')
或
solver.net.copy_from('modelname. caffemodel')net的forward()和backward()所需要的參數中,blobs是一個list的字串,start和end都是一個字串,這些字串都是layer的名稱(使用net.blobs.keys()可以查看)。因為呼叫forward()和backward()後,會回傳某些layer中的資料回來,blobs參數就是讓我們自定義還想"多"回傳哪些layer的blob。start和end用來表示要forward和backward的layer區間。kwargs是一個dict,可以讓我們指定某個layer要使用什麼樣的資料,我們可以使用
{'data1':val1, 'data2':val2, ...}net.forward_all(data1=val1, data2=val2, ...)caffe的layer中有一個叫做HDF5Output,用處是將我們網路的結果輸出。若要使用,要注意他的input要有兩個[4](通常是一個data、一個label),然後使用
hdf5_output_param {
    file_name: "result.h5"
}pycaffe中,forward、backward的參數kwargs其實是python中的keyword arguments,可以自己指定input,並會以dict的方式傳入函數[6]。
在caffe中使用dummy_layer的方式
layer {
name: "dummy"
type: "DummyData"
top: "dummy"
dummy_data_param {
shape {
dim: ...
dim: ...
}
data_filler {
type: "uniform"
min: ...
max: ...
}
}
}
小心網路上的範例把layer打成layers,會出錯誤。
[2] http://nbviewer.jupyter.org/github/BVLC/caffe/blob/master/examples/net_surgery.ipynb
[3] http://www.mathworks.com/help/matlab/ref/hdf5read.html
[4] https://github.com/BVLC/caffe/issues/750
[5] http://docs.h5py.org/en/latest/high/dataset.html
[6] http://stackoverflow.com/questions/1419046/python-normal-arguments-vs-keyword-arguments
[3] http://www.mathworks.com/help/matlab/ref/hdf5read.html
[4] https://github.com/BVLC/caffe/issues/750
[5] http://docs.h5py.org/en/latest/high/dataset.html
[6] http://stackoverflow.com/questions/1419046/python-normal-arguments-vs-keyword-arguments
2016年1月18日 星期一
一些有關caffe使用multi label或regression的文章
https://github.com/BVLC/caffe/issues/1698#issuecomment-70211045
caffe可以做multi label
http://stackoverflow.com/questions/33140000/how-to-feed-caffe-multi-label-data-in-hdf5-format
http://stackoverflow.com/questions/31774953/test-labels-for-regression-caffe-float-not-allowed/31808324#31808324
如何利用HDF5格式製作multi label data
https://github.com/BVLC/caffe/pull/523
multi label的討論串
https://github.com/BVLC/caffe/issues/512
regression的討論串
2016年1月16日 星期六
GraphViz's executables not found
在Caffe中使用draw_net.py,若出現GraphViz's executables not found時,可用
brew install graphviz
參考
2016年1月11日 星期一
一些筆記
http://nbviewer.ipython.org/github/BVLC/caffe/blob/master/examples/00-classification.ipynb
官方推薦的pycaffe教學
http://wubinblog.com/deep%20learning/2015/07/13/Use_Caffe_For_Classification/
http://blog.csdn.net/deeplearninglc007/article/details/40086503
http://closure11.com/caffe%E5%9C%A8python%E4%B8%AD%E4%BD%BF%E7%94%A8%E5%86%85%E5%AD%98%E6%95%B0%E6%8D%AEmemorydata%E8%BF%9B%E8%A1%8C%E8%AE%AD%E7%BB%83/
Caffe中文文章
http://deepdish.io/2015/04/28/creating-lmdb-in-python/
用python創建LMDB的教學,但label只能一個數字
https://groups.google.com/forum/#!topic/caffe-users/6OOcM-XfvOI
提到如何將testing時最後的label輸出
http://blog.csdn.net/visionfans/article/details/48400147
reshape時發現blob的維度超過上限了
https://github.com/Russell91/nlpcaffe/issues/2
https://github.com/BVLC/caffe/issues/2006
遇到儲存snapshot時發生錯誤,可能是因為資料太大,要將維度降低
http://dirlt.com/caffe.html
http://www.cnblogs.com/dupuleng/articles/4370296.html
中文教學,有提到train_val.prototxt和deploy.prototxt的差別,基本上train_val需要指定訓練資料路徑,表示是用來訓練(改變)model的,而deploy則只有指定輸入資料的大小形狀,是model訓練完後拿來用的(不改變model)。
https://groups.google.com/forum/#!topic/caffe-users/8J_J8tc1ZHc
什麼是lr_mult和decay_mult,以及為何有兩個(一個是weight,一個是bias)
https://www.quora.com/Is-there-a-recurrent-neural-networks-toolkit
提到有哪些RNN的工具
http://jeffdonahue.com/lrcn/
caffe有RNN的版本
https://github.com/BVLC/caffe/pull/2033
介紹
https://developer.apple.com/library/mac/documentation/Accelerate/Reference/BLAS_Ref/#//apple_ref/c/func/cblas_sgemm
一些blas的api
http://deeplearning.net/tutorial/lstm.html
LSTM介紹
http://openhome.cc/Gossip/Python/WithAs.html
python中with as的教學。基本上就是簡化讀寫檔案時所需的try...except...final。
http://tech.seety.org/python/python_imaging.html
python PIL影像處理函式庫
http://stackoverflow.com/questions/874461/read-mat-files-in-python
python讀matlab的mat檔的方式
http://stackoverflow.com/questions/120656/directory-listing-in-python
在python中使用os列出目錄資訊的方法。其中,os.walk回傳的generator是種有iterator功能的東西
https://wiki.python.org/moin/Generators
可利用他enumerate的功能來做快速迭代
http://stackoverflow.com/questions/522563/accessing-the-index-in-python-for-loops
http://www.cnblogs.com/vivilisa/archive/2009/03/19/1417083.html
http://www.tutorialspoint.com/python/python_tuples.htm
在python中,使用[1,2,3]是list,使用(1,2,3)是tuple,兩者的差異在於tuple是不能改變其內容的(immutable),其他用法
http://stackoverflow.com/questions/4344017/how-can-i-get-the-concatenation-of-two-lists-in-python-without-modifying-either
可利用list1+list2將兩個list接起來
http://stackoverflow.com/questions/4151128/what-are-the-differences-between-numpy-arrays-and-matrices-which-one-should-i-u
numpy中,array和matrix的差別在於:matrix只能是二維的,而array可以是任意d維的。
http://docs.scipy.org/doc/numpy-1.10.1/reference/generated/numpy.matrix.html
宣告一個matrix的方法
http://docs.scipy.org/doc/numpy-1.10.0/reference/generated/numpy.concatenate.html
將兩個array接起來的方法
找出array中非零個數的方法
http://docs.scipy.org/doc/numpy-1.10.1/reference/generated/numpy.nonzero.html
PIL Image儲存影像的方法
http://stackoverflow.com/questions/14452824/how-can-i-save-an-image-with-pil
http://effbot.org/imagingbook/decoder.htm
http://stackoverflow.com/questions/16720682/pil-cannot-write-mode-f-to-jpeg
影像的mode種類,有RGB、grayscale等,及其設定方法
array增加singleton的方法(singleton就是大小只有1的維度,它應該可以刪除,但有時候array形狀有限定時會需要增加這個維度)
http://stackoverflow.com/questions/9510252/efficient-way-to-add-a-singleton-dimension-to-a-numpy-vector-so-that-slice-assig
http://docs.scipy.org/doc/numpy-1.10.1/reference/generated/numpy.reshape.html
reshape的用法。array中resize和reshape的差別:reshape是回傳resize後的array,resize是直接改變array本身
http://stackoverflow.com/questions/53162/how-can-i-do-a-line-break-line-continuation-in-python
python要將一行code打成多行,只要直接換行就好了,但是縮排還是要縮
http://mathesaurus.sourceforge.net/matlab-numpy.html
python和matlab函式的對應表
2016年1月5日 星期二
有關於library的分別、製作及用法
這是一篇對於library非常好的中文說明
https://www.ptt.cc/man/C_and_CPP/DBF2/D139/DA10/M.1212250886.A.DF4.html
https://www.ptt.cc/man/C_and_CPP/DBF2/D139/DA10/M.1212250886.A.DF4.html
python property and private
有關於python property的用法
http://www.programiz.com/python-programming/property
這篇有非常詳盡且清楚的解釋
http://openhome.cc/Gossip/Python/Property.html
這篇有講到deletor及一點點其他用法
http://stackoverflow.com/questions/1641219/does-python-have-private-variables-in-classes
這裡有提到python沒有嚴格的規定private是不能被access的
http://www.programiz.com/python-programming/property
這篇有非常詳盡且清楚的解釋
http://openhome.cc/Gossip/Python/Property.html
這篇有講到deletor及一點點其他用法
http://stackoverflow.com/questions/1641219/does-python-have-private-variables-in-classes
這裡有提到python沒有嚴格的規定private是不能被access的
訂閱:
文章 (Atom)